


Now Reading: OpenAI เตรียมติดลายน้ำล่องหนรับกฎ EU ช่วยบอกที่มาข้อความ AI
-
01
OpenAI เตรียมติดลายน้ำล่องหนรับกฎ EU ช่วยบอกที่มาข้อความ AI


OpenAI เดินหน้ารับมือข้อกำหนด AI Act ของ EU เตรียมเพิ่มระบบลายน้ำที่มองไม่เห็นในข้อความที่สร้างโดย AI เพื่อช่วยระบุที่มาของเนื้อหา พร้อมย้ำถึงข้อจำกัดและไม่ควรใช้เป็นหลักฐานตัดสินว่าเนื้อหาเขียนโดย AI หรือมนุษย์แบบ 100%
OpenAI จะเริ่มใส่ลายน้ำในข้อความจาก ChatGPT และ Codex สำหรับผู้ใช้งานในสหภาพยุโรป ภายในไม่กี่สัปดาห์ข้างหน้า โดยจะยังไม่เปิดใช้เป็นค่าเริ่มต้นทั่วโลกในทันที เพื่อให้บริษัทได้เรียนรู้จากการใช้งานจริงและประเมินประสิทธิภาพของระบบเพิ่มเติม
ส่วนฝั่งลูกค้าที่ใช้งาน OpenAI API ทั่วโลก สามารถเลือกเปิดใช้ระบบลายน้ำกับโมเดลที่รองรับได้ตั้งแต่วันนี้ โดยค่าเริ่มต้นจะยังคงปิดฟีเจอร์นี้เอาไว้

ลายน้ำแบบมองไม่เห็น ทำงานอย่างไร?
เทคโนโลยีที่ OpenAI ใช้มีชื่อว่า textGrain ซึ่งจะแทรกสัญญาณทางสถิติที่มองไม่เห็นเข้าไปในกระบวนการเลือกคำของโมเดล จากนั้นระบบตรวจจับจะค้นหาสัญญาณดังกล่าวเพื่อประเมินว่าข้อความมีลายน้ำของ OpenAI หรือไม่
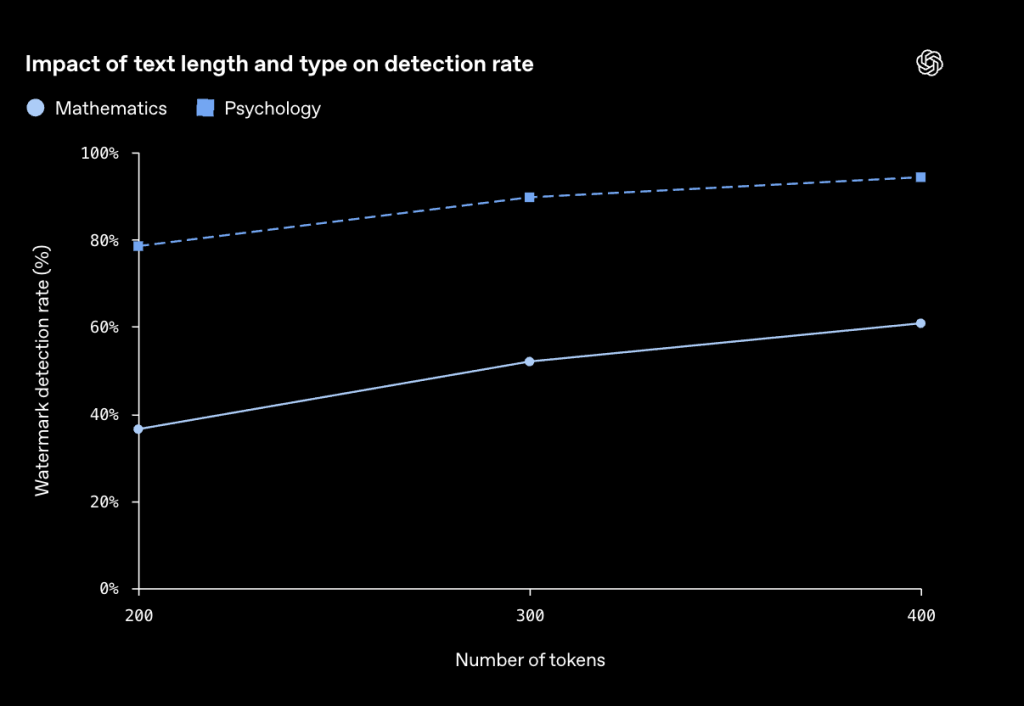
OpenAI ระบุว่า จากการทดสอบ textGrain มีประสิทธิภาพเทียบเท่าหรือดีกว่าวิธีอื่นที่นำมาเปรียบเทียบ รวมถึง SynthID สำหรับข้อความ แต่บริษัทก็ยอมรับว่า ผลการทดสอบในสภาพแวดล้อมที่ควบคุมได้ ไม่ได้หมายความว่าระบบจะตรวจจับได้แม่นยำในทุกสถานการณ์จริง เช่น หากข้อความมีความยาวประมาณ 200 โทเค็น ระบบตรวจจับลายน้ำได้ราว 80% ที่อัตรา False Positive เป้าหมาย 1% ขณะที่ข้อความยาว 400 โทเค็นสามารถตรวจจับได้ประมาณ 95%
อีกข้อจำกัดสำคัญคือ การแก้ไขข้อความสามารถทำให้ลายน้ำอ่อนลง โดยการเปลี่ยนคำเพียง 10% เป็นคำที่มีความหมายใกล้เคียงกัน อัตราการตรวจจับลดลงจากประมาณ 92% เหลือ 66% และหากแก้ไข 25% อัตราการตรวจจับจะเหลือเพียงประมาณ 17%
OpenAI ยังไม่เปิดเครื่องมือตรวจจับให้ทุกคน
ด้วยข้อจำกัดดังกล่าว OpenAI จะเปิดให้เข้าถึงเครื่องมือตรวจจับลายน้ำในระยะแรกเฉพาะ นักวิจัยและองค์กรผู้เชี่ยวชาญที่ผ่านการอนุมัติ เพื่อช่วยประเมินความน่าเชื่อถือและพัฒนาเทคโนโลยีต่อไป
gonjv’0kdระบบยังสามารถเกิดได้ทั้ง False Positive หรือระบุว่ามีลายน้ำทั้งที่ไม่มี และ False Negative หรือไม่พบลายน้ำทั้งที่มีอยู่จริง นอกจากนี้ OpenAI ระบุว่ากำลังพิจารณาเปิดเทคโนโลยี textGrain แบบโอเพนซอร์สในอนาคต เพื่อให้ภายนอกสามารถนำไปศึกษาและพัฒนาต่อยอดได้
มีลายน้ำ ไม่ได้แปลว่า AI เขียนทั้งหมด
OpenAI ย้ำว่า ลายน้ำข้อความมีหน้าที่เพียงช่วยระบุว่า ระบบของ OpenAI มีส่วนสร้างหรือประมวลผลเนื้อหาหรือไม่ แต่ไม่ได้บอกว่า AI มีส่วนร่วมมากน้อยแค่ไหน ลายน้ำนี้ไม่สามารถบอกได้ว่าใครเป็นเจ้าของข้อความ ใครเป็นผู้รับผิดชอบ หรือผู้ใช้มีส่วนแก้ไขและสร้างสรรค์เนื้อหามากน้อยเพียงใด รวมถึงไม่สามารถใช้ยืนยันว่าข้อมูลในข้อความนั้นถูกต้องหรือเป็นเท็จ
ที่สำคัญ การตรวจไม่พบลายน้ำก็ไม่ได้หมายความว่าข้อความนั้นเขียนโดยมนุษย์ เพราะข้อความอาจสั้นเกินไป ถูกแก้ไข แปลภาษา สร้างด้วยโมเดลที่ไม่รองรับ หรือถูกสร้างขึ้นก่อนระบบลายน้ำจะเริ่มใช้งาน
OpenAI ใช้หลายวิธีตรวจสอบที่มาของคอนเทนต์
OpenAI ระบุว่าไม่มีเทคโนโลยีใดเพียงเทคโนโลยีเดียวที่สามารถระบุที่มาของคอนเทนต์ได้อย่างสมบูรณ์ บริษัทจึงใช้แนวทางหลายชั้น ทั้ง Content Credentials ตามมาตรฐาน C2PA, ลายน้ำ SynthID สำหรับภาพและเสียง รวมถึงเครื่องมือ Verify และ Content Provenance API
สำหรับข้อความ บริษัทจะเริ่มจากการใช้งานในยุโรปและเปิดให้ลูกค้า API เลือกใช้งานได้ ก่อนนำข้อมูลจากการใช้งานจริงมาปรับปรุงระบบ
ที่มา openai